强化学习入门——倒立摆(CartPole)
强化学习入门——倒立摆(CartPole)
环境配置
官网下载最新版本的gymnasium(原gym已经迁移到了gymnasium)
pip install gymnasium
pip install swig
pip install "gymnasium[box2d]"
运行测试代码:
import gymnasium as gym
import time

# 生成环境
env = gym.make("CartPole-v1", render_mode="human")
# 环境初始化
state = env.reset()

episode_over = False
while not episode_over:
    # 渲染画面
    env.render()
    # 从动作空间随机获取一个动作
    action = env.action_space.sample()
    # agent与环境进行一步交互
    observation, reward, terminated, truncated, info = env.step(action)

    print("state = {0}; reward = {1}".format(state, reward))
    time.sleep(0.5)
    episode_over = terminated or truncated
# 环境结束
env.close()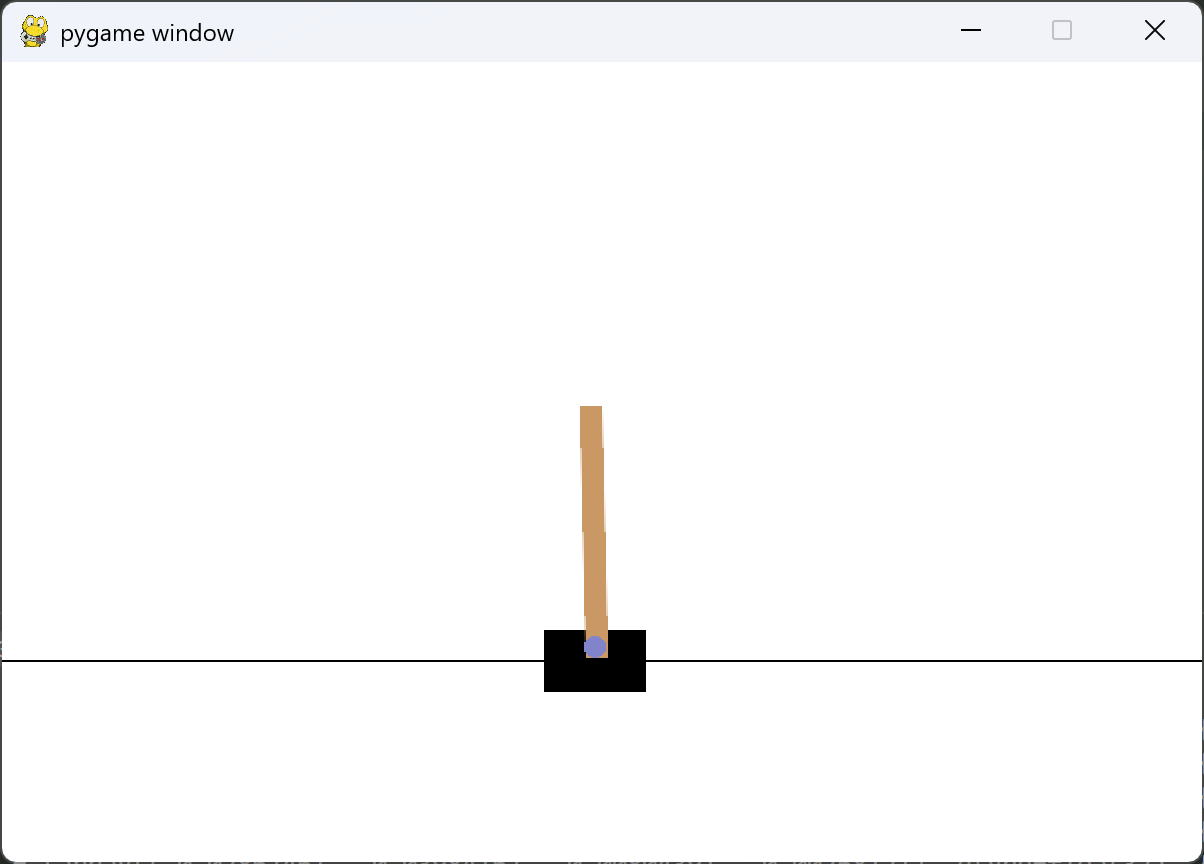
中间使用sleep暂停防止一闪而过看不清,render_mode="human"可以指定渲染模式,这里设置成可视化方便观察
action = env.action_space.sample()随机从动作空间选择一个,之后env.step()与环境交互,并获得新环境,以及奖励
分析模型
state = (array([ 0.01489538, -0.03941276, 0.00729594, -0.01914121], dtype=float32), {})
可以发现state有4个维度,应当代表木棍和小车的状态,分别是小车的位置,小车速度,杆子角度,以及杆的角速度
本题的动作空间为{0,1},表示小车往左或者往右移动
目标是尽可能长时间保持杆直立,默认情况下,每走一步都会获得+1的奖励,包括终止步骤。 由于环境的时间限制,v1的默认奖励阈值为500,可以认为到500就通关了
以下情况会结束:
- 终止:极角大于±12°
- 终止:小车位置大于±2.4(小车中心到达显示屏边缘)
- 截断:情节长度大于 500
可以自由设置每秒的步数
envs = gym.make_vec("CartPole-v1", num_envs=3, vectorization_mode="vector_entry_point")相关知识
由于初步学习,先从比较简单的算法入手,主要学习强化学习的相关概念并熟悉流程。这里选择DQN算法。 DQN是Qlearn的一种,通过神经网络来让Q值网络和目标网络 两个网络结构相同,Q值网络用来正常训练,在过程中不断迭代Q值。而目标网络用于TD(时分插叙算法)计算目标,目标网络不会主动更新,而是每隔一段时间将Q值网络的参数复制到目标网络。 拆成两个网络是为了防止过拟合,保持训练过程稳定。
构建训练算法
构建神经网络
这一步相对简单,就是设计一个接受输入状态空间,输出动作空间的神经网络。由于环境可以直接获取相关参数,因此不需要CNN,训练速度和效果也会好很多。
import torch
import torch.nn as nn

class QNet(nn.Module):
    def __init__(self, state_dim, action_dim) -> None:
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(state_dim, 64),
            nn.ReLU(),
            nn.Linear(64, 128),
            nn.ReLU(),
            nn.Linear(128, 64),
            nn.ReLU(),
            nn.Linear(64, action_dim),
        )

    def forward(self, x):
        return self.net(x)
创建Agent
这一步比较复杂
初始配置
主要是定义两个神经网络
class QAgent:
    def __init__(self, state_dim, action_dim):
        self.q_net = QNet(state_dim, action_dim)
        self.target_net = QNet(state_dim, action_dim)
        # 设置成相同参数
        self.target_net.load_state_dict(self.q_net.state_dict())
        self.step_q_target = config["step_q_target"]
        self.opt = torch.optim.Adam(lr=config["learning_rate"])
        self.memory = deque(maxlen=config["memory_size"])
        self.epsilon = config["epsilon"]
        self.gamma = config["gamma"]
gamma是折扣因子
动作选择
然后从最简单的动作选择开始。使用了ε-贪婪策略的动作选择过程如下:
- 生成一个随机数
- 如果随机小于epsilon,随机从动作空间选择一个动作
- 如果随机大于epsilon,使用Q网络选择动作
epsilon的作用是为了让Agent倾向于探索新策略
    def choose_action(self, state) -> int:
        # 动作选择
        if np.random.rand() < self.epsilon:
            return np.random.randint(0, 2)
        else:
            q_values = self.q_net(torch.FloatTensor(state))
            return q_values.detach().numpy().argmax()
q_values.detach()创建了一个新的张量,它与q_values具有相同的数值,但不会记录计算图。这是为了防止在后续操作中不小心对原始Q网络进行梯度更新 然后转化成numpy的张量并返回最大动作的索引
经验回放
储存经验,用一个四元组来表示:
    def store_experience(self, state, action, reward, next_state, done):
        self.memory.append((state, action, reward, next_state, done))
这里多存了一个Done是作为结束标记,如果杆子倒下,意味着游戏已经结束了,后续的状态是无效的,因为游戏会重置,这样可以避免Q值估计偏差。已经结束的episode的经验不应该持续影响后续状态的Q值。
然后是使用这些经验来训练模型,更新参数,主要依据是贝尔曼方程
- 首先随机选取一定数量(通常设置为batch_size)的经验
- 对每个经验,使用Q值网络来计算当前状态预计回报,用目标网络计算计算下一状态,得到时分差序的目标
- 计算损失,梯度下降,更新参数
    def train(self):
        if len(self.memory) < self.batch_size:
            return  # 经验不足
        batch = random.sample(self.memory, self.batch_size)
        states, actions, rewards, next_states, dones = zip(*batch)  # 得到各个向量
        states = torch.FloatTensor(states)
        actions = torch.LongTensor(actions)
        rewards = torch.FloatTensor(rewards)
        next_states = torch.FloatTensor(next_states)
        dones = torch.FloatTensor(dones)

        # 1. 计算当前状态动作回报
        # 2. 选择实际采用的动作的回报
        # 3. 转化成一维数组
        now_q = self.q_net(states).gather(1, actions.unsqueeze(1)).squeeze()

        with torch.no_grad():
            next_q = self.target_net(next_states).max(1)[0]  # 选取每种状态的最优动作
            target_q = rewards + self.gamma * next_q * (1 - dones)
        loss = self.loss_fn(now_q, target_q)

        self.opt.zero_grad()
        loss.backward()
        self.opt.step()

        # 更新目标网络
        self.step_count += 1
        if self.step_count % self.step_q_target == 0:
            self.target_net.load_state_dict(
                {k: v.clone() for k, v in self.q_net.state_dict().items()}  # ※深拷贝
            )
now_q = self.q_net(states).gather(1, actions.unsqueeze(1)).squeeze()这句一开始可能不太好理解,这段代码的作用选择输出中真正选择的动作的价值
策略评估
可以隔一段时间评估一次模型表现,监督模型的训练 先将episode置为零,避免探索,在环境中执行若干次,计算平均的Reward
    def evaluate(self):
        tmp = self.epsilon
        self.epsilon = 0
        rewards = []

        for _ in range(self.eval_episodes):
            state = env.reset()[0]
            now_reward = 0
            while True:
                action = self.choose_action(state)
                next_state, reward, done, _, _ = env.step(action)
                now_reward += reward
                state = next_state
                if done:
                    break
            rewards.append(now_reward)
        self.epsilon = tmp
        return np.mean(rewards)
训练过程
初始化环境
# 设置随机数种子
SEED = 42
random.seed(SEED)
np.random.seed(SEED)
torch.manual_seed(SEED)

env = gym.make("CartPole-v1")
创建模型
state_dim = env.observation_space.shape[0]
action_dim = env.action_space.n
agent = QAgent(state_dim, action_dim)
回合训练
引入tqdm进度条,没进度条能把人急死...... 每轮episode不断探索动作,保存经验,训练,时不时评估当前模型。
t = tqdm(range(config["episode"]))

best_reward = 0.0

for episode in t:
    # 一轮游戏,从环境重置到游戏结束
    state = env.reset()[0]
    total_reward = 0

    while True:
        action = agent.choose_action(state)
        next_state, reward, done, _, _ = env.step(action)
        agent.store_experience(state, action, reward, next_state, done)
        agent.train()

        total_reward += reward
        state = next_state
        if done or total_reward > config["max_reward"]:
            break
        t.set_postfix(best_reward=best_reward, now_reward=total_reward)
    agent.epsilon = max(config["epsilon_min"], agent.epsilon * config["epsilon_decay"])

    # 评估模型
    if episode % config["eval_interval"] == 0:
        # eval_env = gym.make("CartPole-v1")
        # reward = agent.evaluate(env=eval_env)
        # eval_env.close()
        reward = agent.evaluate(env=env)

        if reward > best_reward:
            best_reward = reward
            t.set_postfix(best_reward=best_reward, now_reward=total_reward)
保存模型
为了防止训练中断或是方便直接使用训练好的模型,最好要保存下来,pytorch内置了保持参数的方法,我们的模型只需要保存q_net的参数即可,因为目标网络的参数是从q_net来的。
录制训练视频
为了节省性能,可能会采用非human的渲染方式,或者训练设备本身没有图形界面,不过gym也提供了录像方式
使用
from gymnasium.wrappers import RecordVideo

test_env = gym.make("CartPole-v1", render_mode="rgb_array")
test_env = RecordVideo(
    test_env, "./dqn_videos", episode_trigger=lambda x: True
)
然后在test_env运行的结果都会被录制下来并保存